程序员茄子
全部
编程
代码
资讯
案例
综合
联系我们
llama.cpp 相关技术文章
php
mysql
shell
go
vue
css
api接口对接
支付接口对接
llama.cpp GGUF 量化:Q8_0 生成速度低于 Q4_K_M,以及 imatrix 与 --tensor-type 的用法
编程
llama.cpp GGUF 量化:Q8_0 生成速度低于 Q4_K_M,以及 imatrix 与 --tensor-type 的用法
2026-09-27 00:04:53
llama.cpp 的 GGUF 量化实操:两阶段流程(convert_hf_to_gguf + llama-quantize)、imatrix 重要性矩阵、--pure/--allow-requantize 风险、--tensor-type 正则与多模态 mmproj 单独量化。附 Llama 3.1-8B 各量化档位的体积与速度对照,Q8_0 生成速度反低于 Q4_K_M 的反直觉点。
int8量化
GGUF
llama.cpp
Q8_0
imatrix
模型量化
编程
4B 端侧模型跑 Agent:Spark-X2.5 本地部署与 Codex 接入实测
2026-09-18 06:56:25
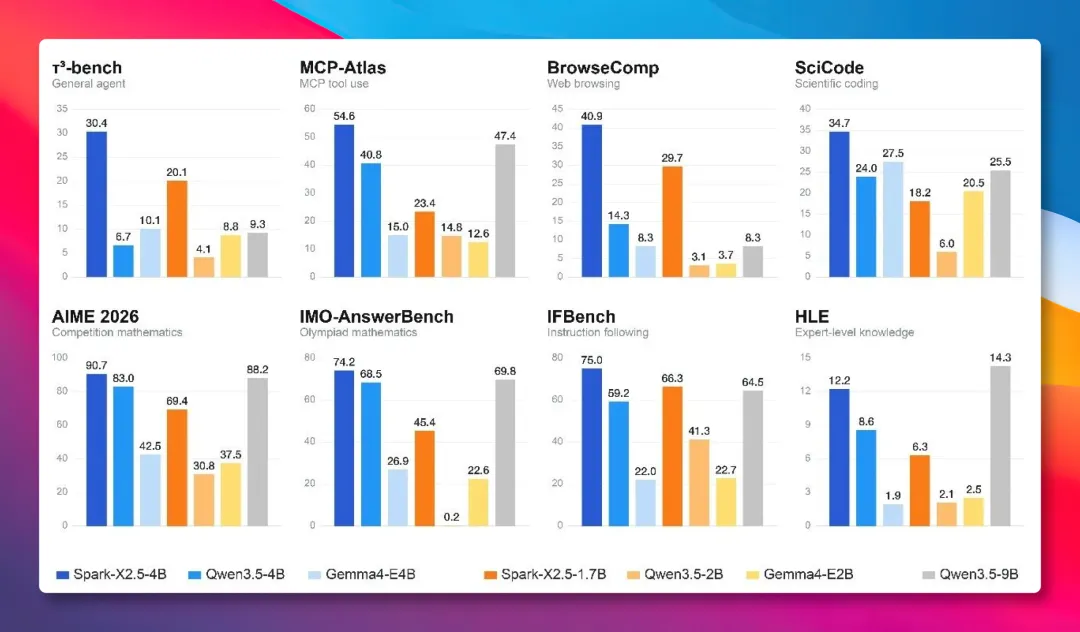
科大讯飞旗下词元星火开源的 Spark-X2.5-1.7B / 4B 端侧模型,实测在一个笔记本上用 llama.cpp 部署、跑通 28 token/s,并接入翻译工具和 Codex。记录一句话让 Agent 自动部署模型、CC Switch 切换供应商、让 4B 模型读完整项目并调用 Archify 技能生成架构图的完整过程,附 Hugging Face / ModelScope / GitHub 地址。
Spark-X2.5
端侧模型
llama.cpp
Codex
Agent
编程
Spark-X2.5 本地实测:把 4B 端侧模型接到 Codex 与翻译工具
2026-09-04 18:05:38
实测科大讯飞旗下词元星火开源端侧模型 Spark-X2.5(1.7B/4B):用 Claude Code 一句话本地部署(llama.cpp),接入翻译工具当离线引擎,并接入 Codex 走完读懂 GitHub 项目、调用技能生成架构图等 Agent 式多步任务,附完整配置与实测数据。
Spark-X2.5
端侧模型
llama.cpp
Codex
Agent
Claude
Code
llmfit 深度拆解:Rust 写就的本地大模型选型神器——一行命令把"显存够不够跑"从玄学变成算术
编程
llmfit 深度拆解:Rust 写就的本地大模型选型神器——一行命令把"显存够不够跑"从玄学变成算术
2026-08-18 08:15:14
llmfit 是一款 Rust 编写的本地大模型选型工具,一行命令自动检测硬件配置,精确计算显存占用,给出 Fit 评分和速度估算,支持 Ollama、llama.cpp、MLX 等多运行时,配可运行代码与最佳实践。
llmfit
Rust
TUI
本地大模型
LLM推理
Ollama
llama.cpp
模型选型
量化
Apple Silicon
GPU
显存计算
MLX
命令行工具
Muse Glimmer 端侧Agent革命:300亿参数模型如何在消费级GPU上跑出生产级性能(2026实战)
编程
Muse Glimmer 端侧Agent革命:300亿参数模型如何在消费级GPU上跑出生产级性能(2026实战)
2026-08-13 18:50:11
深度拆解Meta 2026年8月发布的Muse Glimmer:300亿参数开放权重Dense模型,4bit量化可在单张RTX 3090/4090上本地运行。涵盖架构设计、知识蒸馏、量化原理、本地部署实战与性能基准测试。
Muse Glimmer
端侧AI
知识蒸馏
4bit量化
Agent本地部署
300亿参数
Meta
Apache 2.0
llama.cpp
Ollama
Meta Muse Glimmer 深度拆解:300亿参数端侧Agent模型的工程革命——从知识蒸馏到4bit量化的完整实战指南(2026)
编程
Meta Muse Glimmer 深度拆解:300亿参数端侧Agent模型的工程革命——从知识蒸馏到4bit量化的完整实战指南(2026)
2026-08-13 18:49:00
深度拆解Meta 2026年8月发布的Muse Glimmer:300亿参数开放权重Dense模型,4bit量化可在单张RTX 3090/4090上本地运行。涵盖架构设计、知识蒸馏、量化原理、本地部署实战与性能基准测试。
Muse Glimmer
端侧AI
知识蒸馏
4bit量化
Agent本地部署
300亿参数
Meta
Apache 2.0
llama.cpp
Ollama
口袋里的 AI 超级大脑:Operit AI 全链路架构深度拆解,从工具调用到移动端自动化的范式革命
编程
口袋里的 AI 超级大脑:Operit AI 全链路架构深度拆解,从工具调用到移动端自动化的范式革命
2026-08-11 12:29:29
深度拆解 Operit AI 的全链路架构:Kotlin协程与Jetpack Compose UI层、MNN与llama.cpp本地推理引擎、PRoot嵌入Ubuntu 24环境、基于无障碍服务的UI自动化、MCP协议与40+工具生态。含15条生产踩坑清单与完整部署指南。
AI Agent
Android
Kotlin
Jetpack Compose
MNN
llama.cpp
MCP
自动化
工具调用
移动开发
llama.cpp 深度拆解:一个纯 C++ 引擎如何让 180K Star 成为端侧 LLM 的事实标准——从 GGUF 格式到多后端架构的全栈解析
编程
llama.cpp 深度拆解:一个纯 C++ 引擎如何让 180K Star 成为端侧 LLM 的事实标准——从 GGUF 格式到多后端架构的全栈解析
2026-08-03 10:45:17
深度拆解llama.cpp四大核心架构:GGUF模型格式设计、GGML计算引擎、8种多后端抽象层、K-Quant/I-Quant量化技术体系,附完整代码示例与性能基准测试
llama.cpp
GGUF
GGML
量化
端侧推理
LLM
C++
推理引擎
多后端
K-Quant
llama.cpp 架构深度拆解:从 GGML 到 GGUF、量化内核到跨平台推理栈,一文吃透本地 LLM 推理工程化
编程
llama.cpp 架构深度拆解:从 GGML 到 GGUF、量化内核到跨平台推理栈,一文吃透本地 LLM 推理工程化
2026-08-01 08:18:35
深度拆解 llama.cpp 全栈架构:从 GGML 到 GGUF 格式演进、K-Quant 量化内核原理、ggml 张量计算图层、libllama 推理逻辑层、10+ 硬件后端调度,以及生产调优实战与踩坑清单。
llama.cpp
GGUF
GGML
量化
本地LLM
CPU推理
GPU加速
跨平台
K-Quant
TurboQuant+深度拆解:极坐标量化+QJL残差编码——2bit KV Cache压缩重构 LLM 推理经济学
编程
TurboQuant+深度拆解:极坐标量化+QJL残差编码——2bit KV Cache压缩重构 LLM 推理经济学
2026-07-28 11:52:16
深度拆解Google ICLR 2026论文TurboQuant及其工程增强TurboQuant+:极坐标量化+QJL残差编码实现2bit KV Cache压缩,配合llama.cpp跨后端(CUDA/ROCm/Metal/Vulkan)生产级落地,附完整代码实战与选型建议
TurboQuant
KV Cache
LLM推理
llama.cpp
量化
显存优化
Walsh-Hadamard
Vulkan
CUDA
ROCm
TurboQuant+ 深度拆解:用 2bit KV Cache 压缩重构 LLM 推理经济学——从 Walsh-Hadamard 旋转到 llama.cpp 生产级落地
编程
TurboQuant+ 深度拆解:用 2bit KV Cache 压缩重构 LLM 推理经济学——从 Walsh-Hadamard 旋转到 llama.cpp 生产级落地
2026-07-28 11:50:04
深度拆解Google ICLR 2026论文TurboQuant及其工程增强TurboQuant+:极坐标量化+QJL残差编码实现2bit KV Cache压缩,配合llama.cpp跨后端(CUDA/ROCm/Metal/Vulkan)生产级落地,附完整代码实战与选型建议
TurboQuant
KV Cache
LLM推理
llama.cpp
量化
显存优化
Walsh-Hadamard
Vulkan
CUDA
ROCm
TurboQuant+ 深度拆解:用 2bit KV Cache 压缩重构 LLM 推理经济学——从 Walsh-Hadamard 旋转到 llama.cpp 生产级落地
编程
TurboQuant+ 深度拆解:用 2bit KV Cache 压缩重构 LLM 推理经济学——从 Walsh-Hadamard 旋转到 llama.cpp 生产级落地
2026-07-28 11:48:24
深度拆解Google ICLR 2026论文TurboQuant及其工程增强TurboQuant+:极坐标量化+QJL残差编码实现2bit KV Cache压缩,配合llama.cpp跨后端(CUDA/ROCm/Metal/Vulkan)生产级落地,附完整代码实战与选型建议
TurboQuant
KV Cache
LLM推理
llama.cpp
量化
显存优化
Walsh-Hadamard
Vulkan
CUDA
ROCm
Shimmy 深度解析:纯 Rust WebGPU 推理引擎如何用一行命令颠覆浏览器端 AI 推理
编程
Shimmy 深度解析:纯 Rust WebGPU 推理引擎如何用一行命令颠覆浏览器端 AI 推理
2026-07-25 15:14:38
深度解析 Shimmy v2.3.0:纯 Rust WebGPU 推理引擎如何实现浏览器端原生运行 GGUF 量化模型,OpenAI API 兼容,零依赖部署。
WebGPU
Rust
GGUF
AI推理
浏览器
llama.cpp
OpenAI API
前端工程
llmfit 深度拆解:一条命令算出你的电脑能跑哪些大模型——硬件感知适配引擎的工程解剖
编程
llmfit 深度拆解:一条命令算出你的电脑能跑哪些大模型——硬件感知适配引擎的工程解剖
2026-07-24 18:44:04
深度拆解 GitHub Trending 开源工具 llmfit:四维评分系统、量化自动试探、MoE 精算、带宽速度模型、Plan 模式与 bench 众包校准,从第一性原理讲透本地大模型的硬件适配方法论。
llmfit
本地大模型
LLM
Rust
量化
Ollama
llama.cpp
Apple Silicon
硬件适配
开源
llmfit 深度拆解:一条命令算清你的机器能跑哪个大模型,Rust 硬件探测与适配度评分引擎全解析
编程
llmfit 深度拆解:一条命令算清你的机器能跑哪个大模型,Rust 硬件探测与适配度评分引擎全解析
2026-07-24 07:14:55
深度拆解 GitHub Trending 破万星的 llmfit:Rust 硬件探测、权重与 KV cache 显存估算公式、内存带宽速度模型、MoE offload 运行模式,附 100 行 Python 复现 mini-llmfit 与工程集成实战。
llmfit
Rust
本地大模型
Ollama
llama.cpp
量化
KV cache
MoE
硬件选型
开源
Tabby 深度实战:用一台消费级 GPU 搭好团队私有的"Copilot"
编程
Tabby 深度实战:用一台消费级 GPU 搭好团队私有的"Copilot"
2026-07-24 01:46:45
深度实战 TabbyML/tabby 自托管 AI 编程助手:三层架构与 llama-server 独立化重构、消费级 GPU 模型选型、Repository Context 语法感知 RAG 索引、FIM Prompt 拼装原理、systemd/nginx 生产部署、压测与 Prometheus 监控全套方案。
Tabby
AI编程
代码补全
自托管
llama.cpp
RAG
Rust
GPU
开源
Copilot
shimmy v2.3.0 深度解析:纯 Rust WebGPU 推理引擎如何让 GGUF 模型跑满你的每一块 GPU
编程
shimmy v2.3.0 深度解析:纯 Rust WebGPU 推理引擎如何让 GGUF 模型跑满你的每一块 GPU
2026-07-23 11:45:35
深度解析纯 Rust WebGPU 推理引擎 shimmy v2.3.0:GGUF 原生加载、OpenAI API 兼容、KV Cache 量化、Flash Attention 等效实现,配 Tauri 桌面应用集成实战与性能基准测试。
shimmy
WebGPU
Rust
GGUF
LLM
llama.cpp
推理引擎
WebAssembly
腾讯混元开源 HyOCR-1.5 深度解读:端到端 OCR 的工程哲学与 DFlash 投机解码完全指南
编程
腾讯混元开源 HyOCR-1.5 深度解读:端到端 OCR 的工程哲学与 DFlash 投机解码完全指南
2026-07-21 12:46:56
2026年7月腾讯混元开源HyOCR-1.5端到端OCR大模型,1B参数OmniDocBench 94.74分霸榜。深度拆解DFlash投机解码6.37倍加速、Agentic Data Flow自动化数据闭环、三阶段训练配方,以及vLLM/llama.cpp全场景部署实战。
HyOCR
HunyuanOCR
腾讯混元
端到端OCR
DFlash
投机解码
多模态模型
文档解析
文字识别
视觉语言模型
OmniDocBench
vLLM
llama.cpp
深度学习
Ollama 深度拆解:从傻瓜式本地大模型部署到底层 llama.cpp 调度器的工程全貌(2026·完整版)
编程
Ollama 深度拆解:从傻瓜式本地大模型部署到底层 llama.cpp 调度器的工程全貌(2026·完整版)
2026-07-20 18:18:40
深度拆解 Ollama 工程架构:Go 服务层封装 llama.cpp、CGO 内存边界、GGUF 量化格式、Modelfile DSL、OpenAI 兼容层、Metal GPU 加速与生产部署实战,配完整 Go/Python/Shell 代码示例。
Ollama
本地大模型
llama.cpp
GGUF
Go
CGO
量化
Apple Silicon
当 C/C++ 遇上 Rust:llama.cpp 与 LiteBox 深度架构对比——2026 年本地 LLM 推理框架的心智模型之战
编程
当 C/C++ 遇上 Rust:llama.cpp 与 LiteBox 深度架构对比——2026 年本地 LLM 推理框架的心智模型之战
2026-07-16 12:50:04
深度对比 llama.cpp 与 LiteBox 两大本地 LLM 推理框架:GGUF 格式设计、K-Quant 量化内核、KV cache 管理、多后端抽象、并发架构,配完整代码实战与性能实测数据。
llama.cpp
LiteBox
GGUF
量化
KV cache
本地LLM
推理框架
Rust
C/C++
模型压缩
Ollama 融资 6500 万美元背后:2026 年本地大模型运行时生态深度拆解——为什么「极简主义」赢了
编程
Ollama 融资 6500 万美元背后:2026 年本地大模型运行时生态深度拆解——为什么「极简主义」赢了
2026-07-16 11:45:03
从 Ollama 6500 万美元融资事件切入,深度拆解 2026 年本地大模型运行时生态:Ollama、llama.cpp、LocalAI、LiteBox、vLLM 的架构设计、性能对比、API 设计、适用场景,配完整代码实战与生产部署踩坑指南。
Ollama
本地大模型
llama.cpp
LocalAI
LiteBox
本地LLM
推理引擎
量化
GGUF
MCP
Ollama 深度拆解:当大模型变成「一个文件」——GGUF、4-bit 量化与 llama.cpp 计算图如何重写本地推理的心智模型
编程
Ollama 深度拆解:当大模型变成「一个文件」——GGUF、4-bit 量化与 llama.cpp 计算图如何重写本地推理的心智模型
2026-07-15 08:45:14
从工程师视角深度拆解 Ollama 与本地大模型推理引擎:GGUF 单文件格式、K-quant/IQ-quant 量化家族、内存带宽墙、llama.cpp 计算图与 KV Cache,配 Modelfile、Python/Go 流式客户端与自量化实战。
Ollama
llama.cpp
GGUF
本地推理
大模型量化
KV Cache
把大模型装进机房:Ollama 本地推理工程化实战——量化、并发、缓存与生产部署一次讲透(2026)
编程
把大模型装进机房:Ollama 本地推理工程化实战——量化、并发、缓存与生产部署一次讲透(2026)
2026-07-14 03:43:32
深度拆解 Ollama 本地大模型推理工程化:从 GGUF 量化原理、MoE 专家调度、推理栈与 KV 缓存,到 Modelfile 定制、自量化、Python 客户端、FastAPI 生产服务、Docker 部署与性能调优,配完整可运行代码与 vLLM 对比。
Ollama
本地大模型
llama.cpp
GGUF量化
大模型部署
AI工程化
隐私计算
推理优化
Ollama深度解析:Go语言打造的本地LLM推理引擎——从Modelfile容器化到GPU调度的完整实战指南
编程
Ollama深度解析:Go语言打造的本地LLM推理引擎——从Modelfile容器化到GPU调度的完整实战指南
2026-07-06 05:48:17
深度解析Ollama本地LLM推理引擎架构与实战
Ollama
本地推理
LLM
Go
llama.cpp
GGUF
GPU
Modelfile
大家都在搜索什么?
devops
易支付
一个官网+多少钱
统一接受回调
统一回调
python
sub
node
宝塔日志
mysql
shell
ElasticSearch
css
vue
api接口对接
2025
支付接口对接
go
php
php回调
上一页
1
2
下一页
共 2 页
到第
页
确定