4B 端侧模型跑 Agent:Spark-X2.5 本地部署与 Codex 接入实测
过去想让 Agent 调用工具干活,基本都得靠上百亿参数的大模型。科大讯飞全资子公司「词元星火」开源了两款端侧模型 Spark-X2.5-1.7B 和 Spark-X2.5-4B,把 Agent 能力装进了小模型里。从官方评测得分看,多项能力超过同尺寸开源模型,Agent 任务这块领先明显。
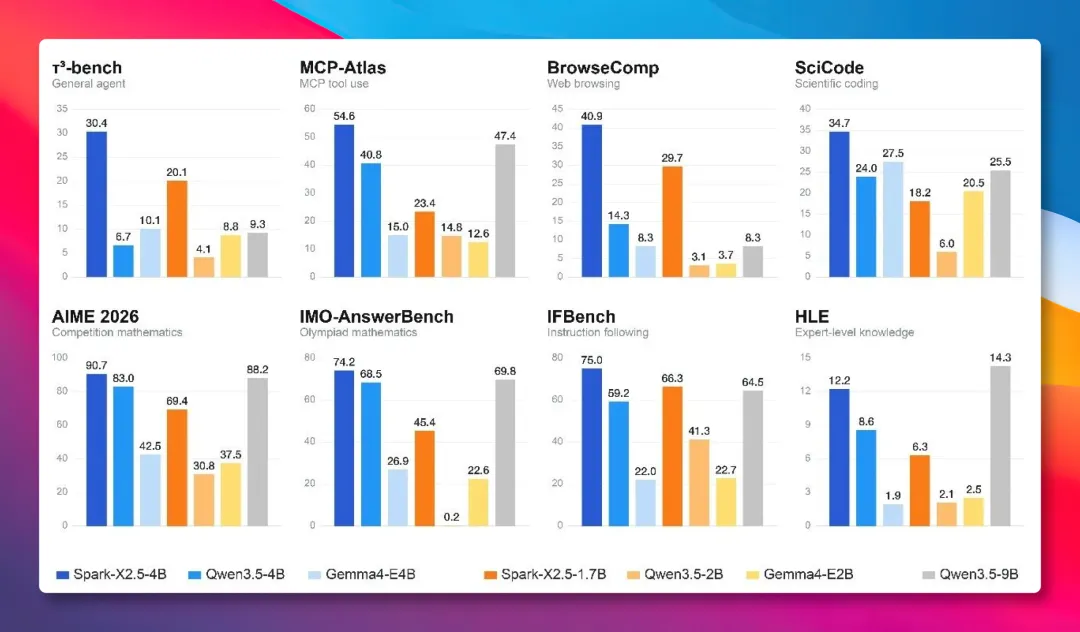
模型还原生支持 100 万 Token 上下文,整个大项目丢进去也装得下,Agent 跑长任务不容易断片。
说实话,一开始看到这个尺寸,我对它的真实能力没抱太大期待。一圈测试下来,把它离线跑在一台笔记本里,能干的活还不少。下面记录我是怎么在本地部署和使用这些端侧模型的。
一句话,让 AI 把模型部署到本地
模型兼容 SGLang、vLLM、llama.cpp 这些主流推理框架,权重开源地址一般在 Hugging Face 或 ModelScope 上。选一个自己熟悉的 Agent 工具,Claude Code 或 Codex 都行,只需发一句话:
帮我在本地部署这个开源模型 https://huggingface.co/XHToken/Spark-X2.5-1.7B,按 README 用 llama.cpp 方式,跑通后起一个本地服务
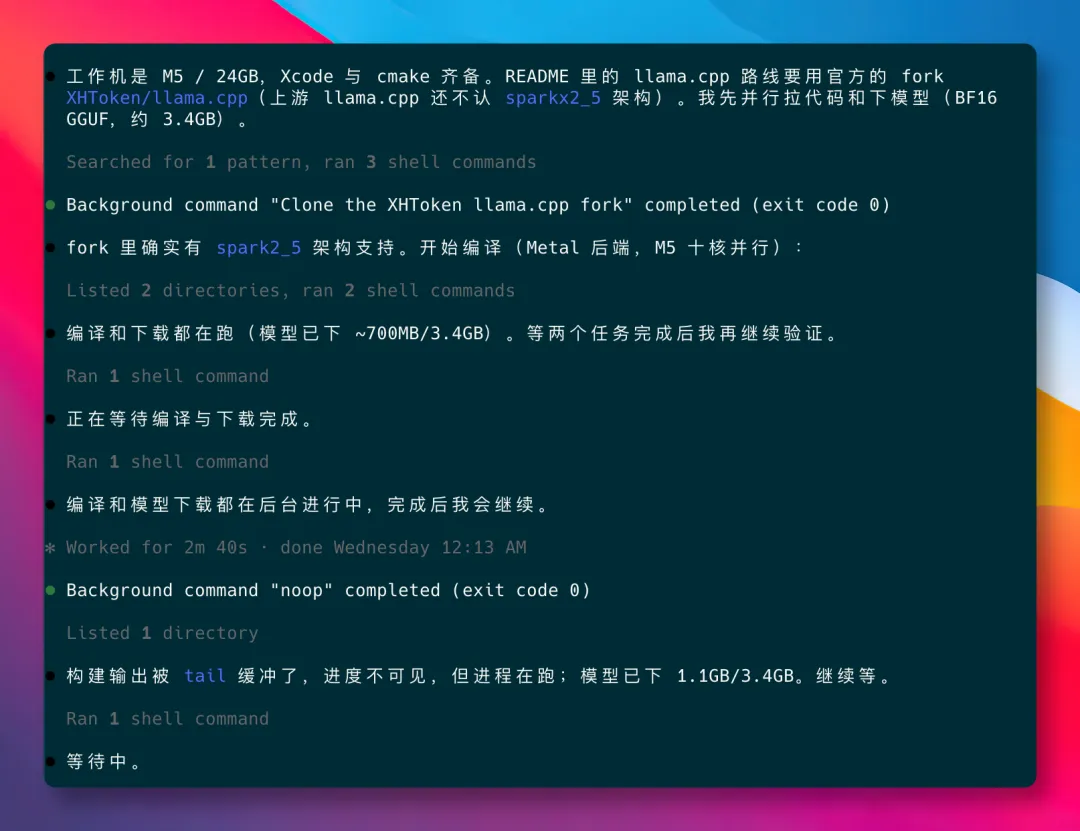
AI 会先检查电脑配置和环境,判断这台机器适不适合部署这个模型。如果适合,就继续下载模型、编译、部署启动服务,全程不需要我插手。
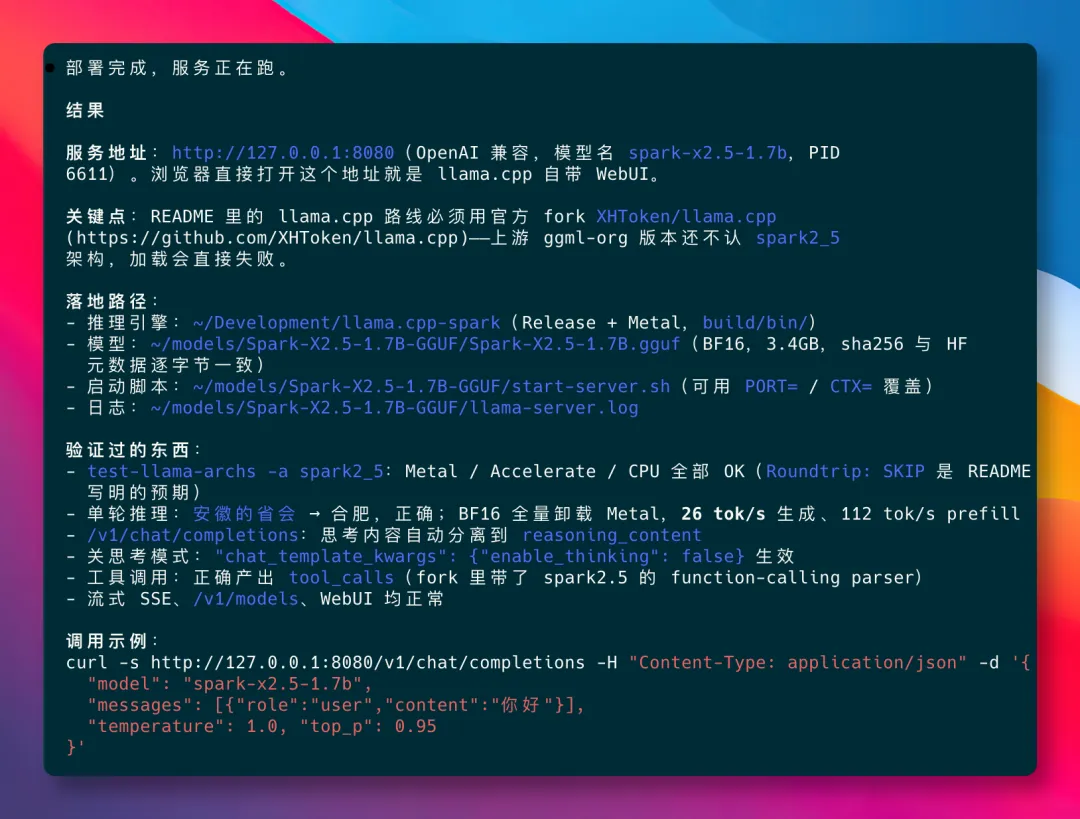
不用多久部署完成,可以把模型接入任何兼容 OpenAI 或 Anthropic 协议的工具。
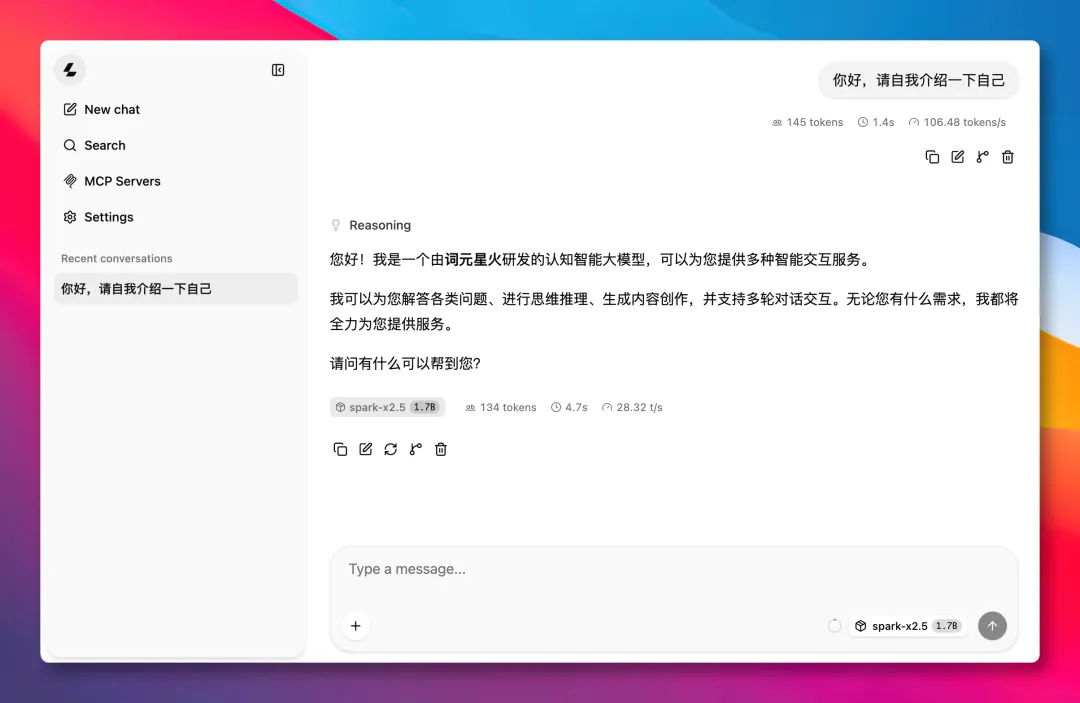
llama.cpp 自带 WebUI,打开浏览器访问服务地址就能直接使用模型。
前面部署的是 Spark-X2.5-1.7B,实测每秒能吐 28 个 token,比预想的流畅。看到这个速度,感觉我这台电脑跑 4B 应该也没压力,于是又让 Claude 帮我部署了一个。
顺手挂到翻译工具上,白嫖一个翻译引擎
模型支持 200 多种语言,部署完成后我第一反应是把它接到电脑里的翻译工具上。
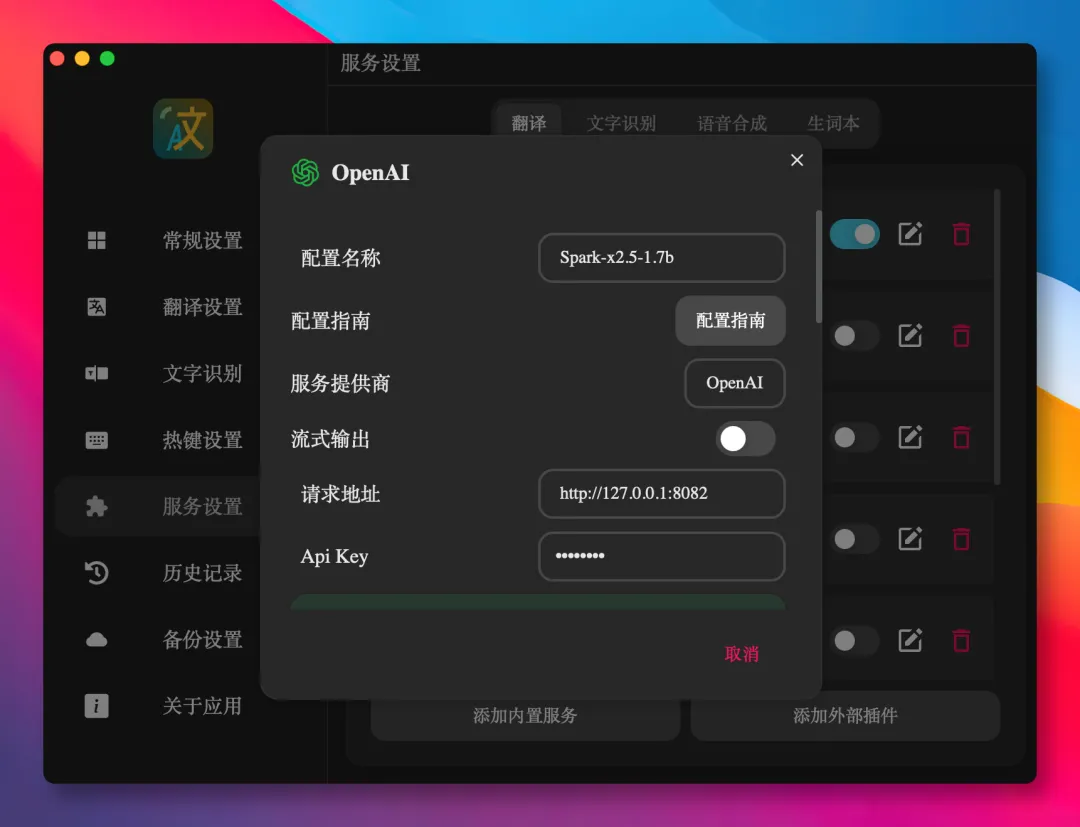
配置不复杂:服务商选 OpenAI,请求地址填本地服务地址,模型名对上,API Key 随便填一个就行。
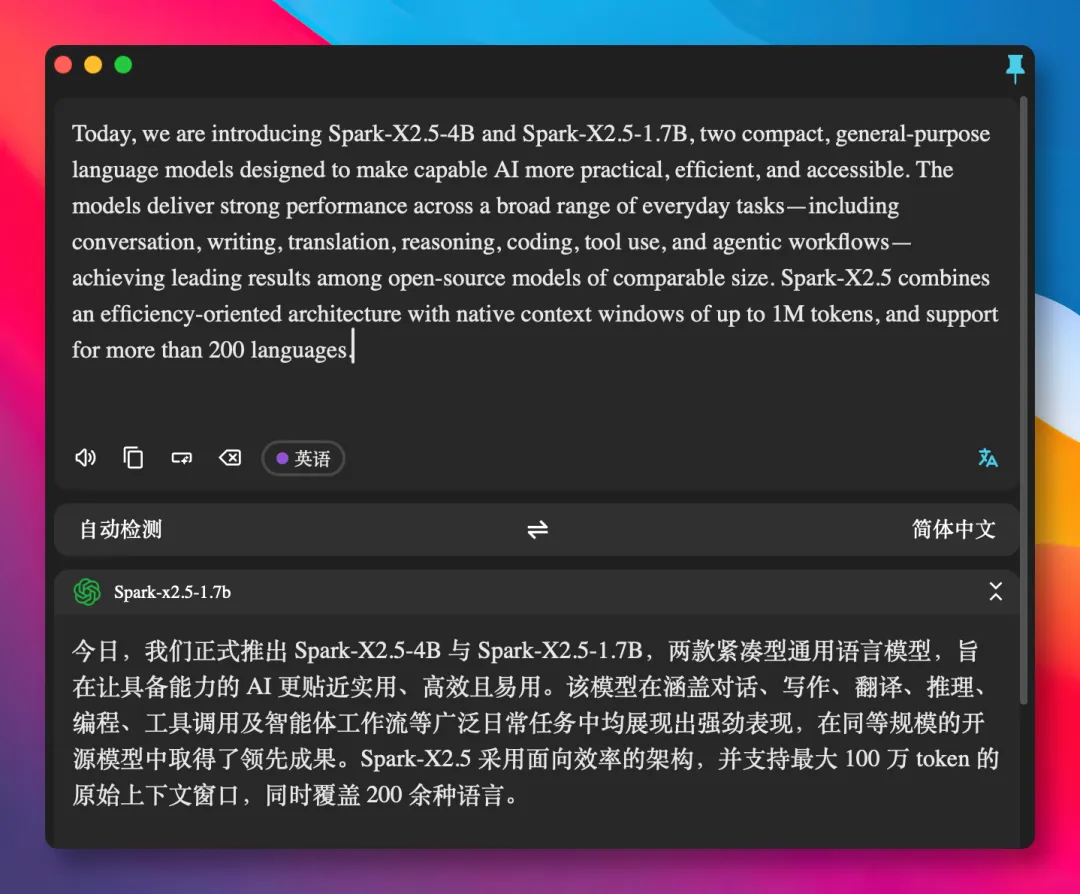
随手从 Spark-X2.5 开源项目的 README 里拿一段英文介绍扔给它,翻译结果几乎瞬间出来,质量还很高。关键是不用花钱,还能本地离线使用。
把 Codex 的大脑,换成本地 4B
接着把 4B 模型接入 Codex,这里用 CC Switch 工具切换,比较方便。接入 Claude Code 也可以,步骤差不多,就不一一演示了。
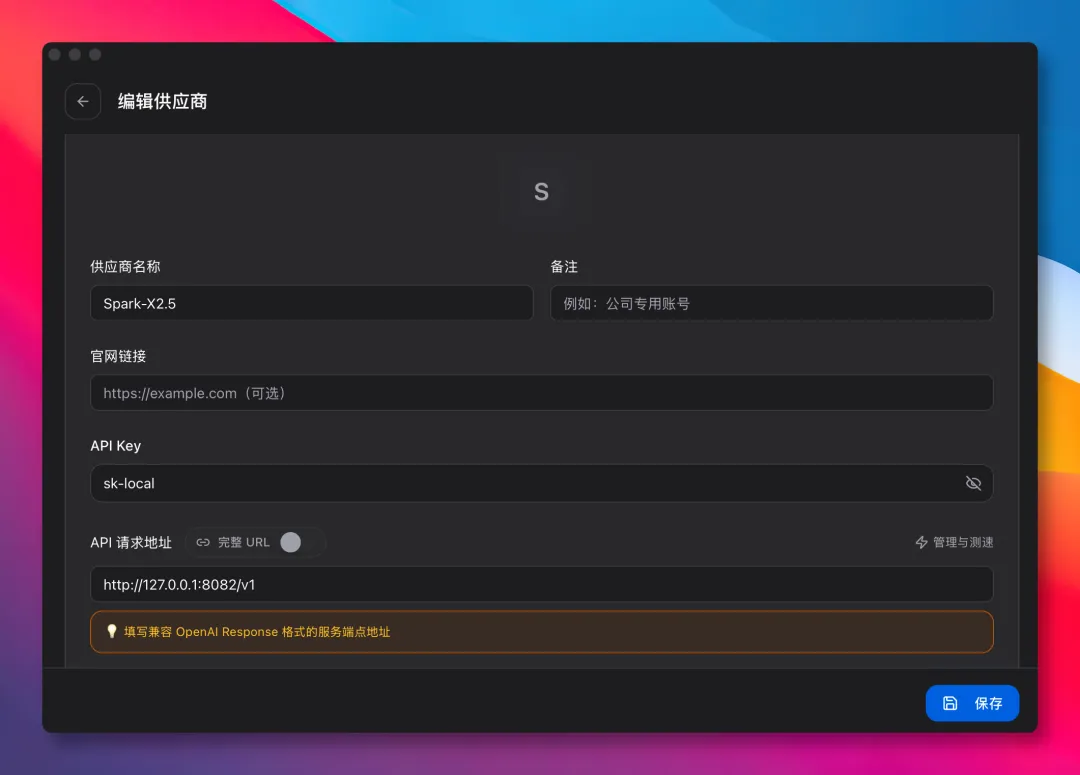
打开 CC Switch 切到 Codex,点击右边加号「新添加供应商」,主要填以下信息。供应商名称和 API Key 可以随便填,其中「API 请求地址」是自己本地部署的服务地址。
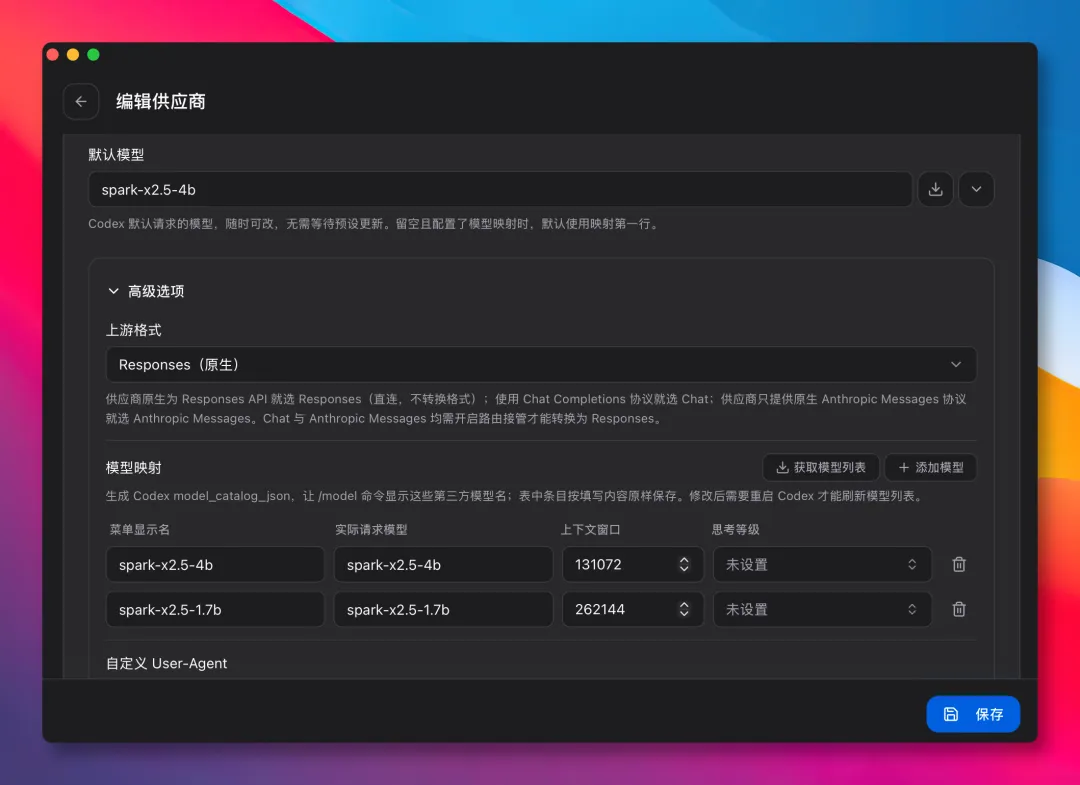
再往下「默认模型」填自己部署的模型 ID,上游格式选择「Responses(原生)」。模型映射里的上下文窗口,根据部署时设置的长度填写,这些有不懂的都可以问 AI。
回到 CC Switch 主页时,记得将新增的供应商启用,也可以顺便测试连接是否正常。接着到终端启动 Codex,在模型位置上看到是 Spark-X2.5-4B,就说明可以使用了。
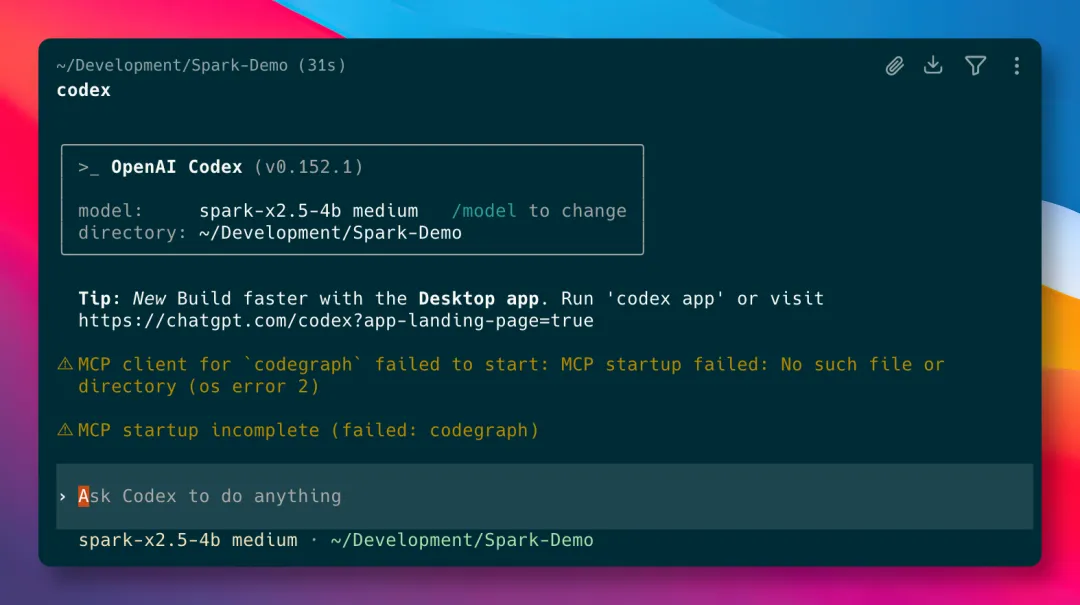
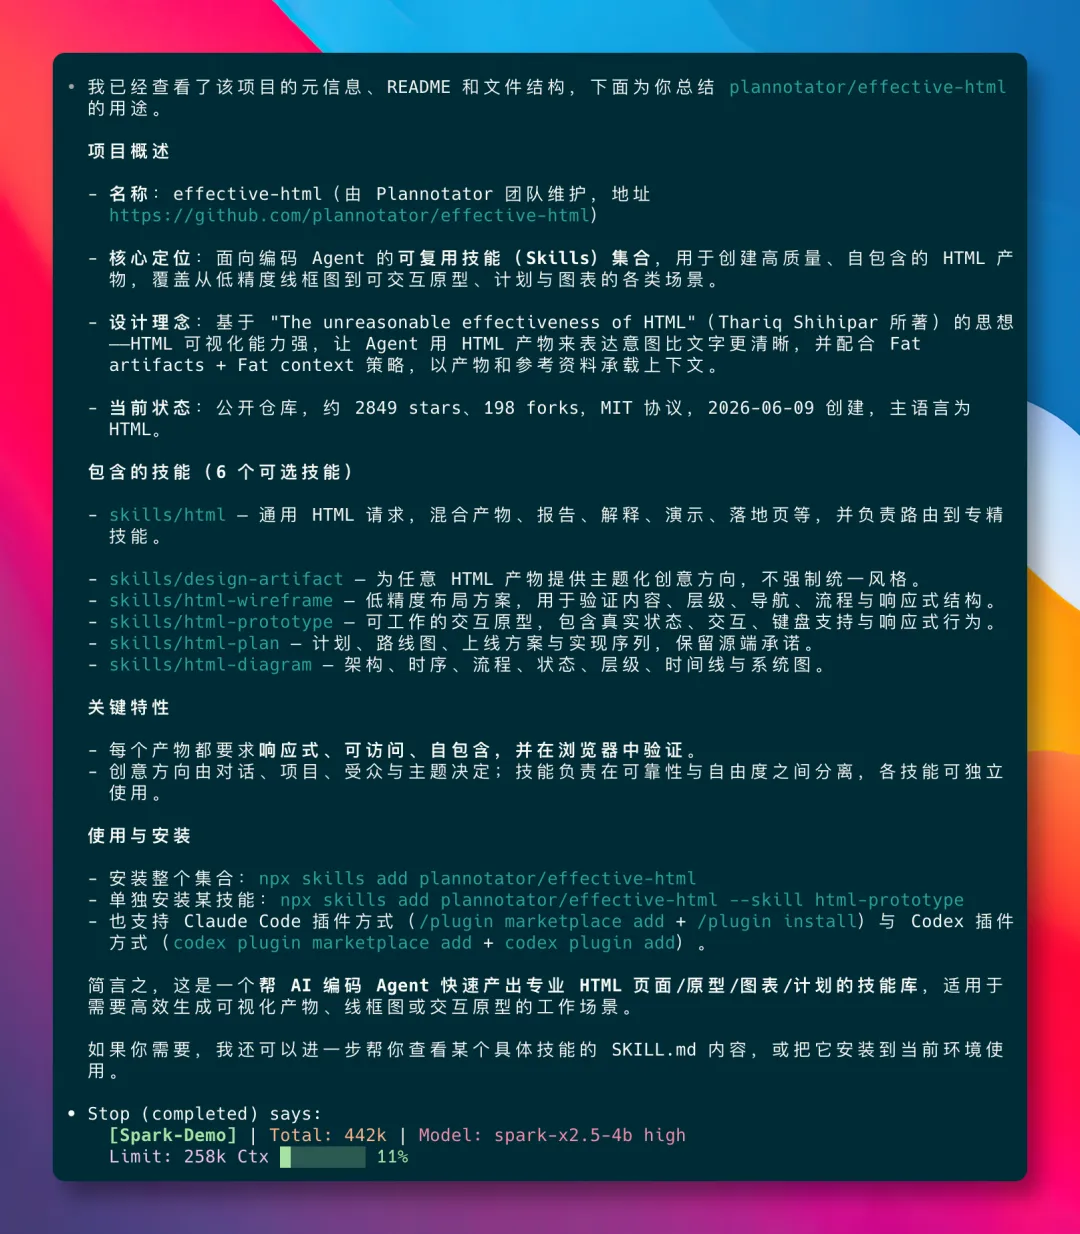
先试个简单的活:只发项目 GitHub 地址给它,让它了解一整个开源项目。它自己调用工具把项目拉到本地,读取代码、查看 README,最后总结出这个项目是干嘛的、有什么特性、怎么安装使用。
接着上难度。之前介绍过的画图技能 Archify,产出的架构图刚好是 HTML 文件,正好可以测试它能否正常调用 Agent 工具的 skill,以及写代码的能力。
直接发一句话,让它用 Archify 技能给项目生成一张架构图,然后观察过程。它先读取技能的使用说明,再查看项目核心文件,确保细节和画图的准确性;了解完项目后调用技能撰写代码生成架构图,整个过程步骤相当多。
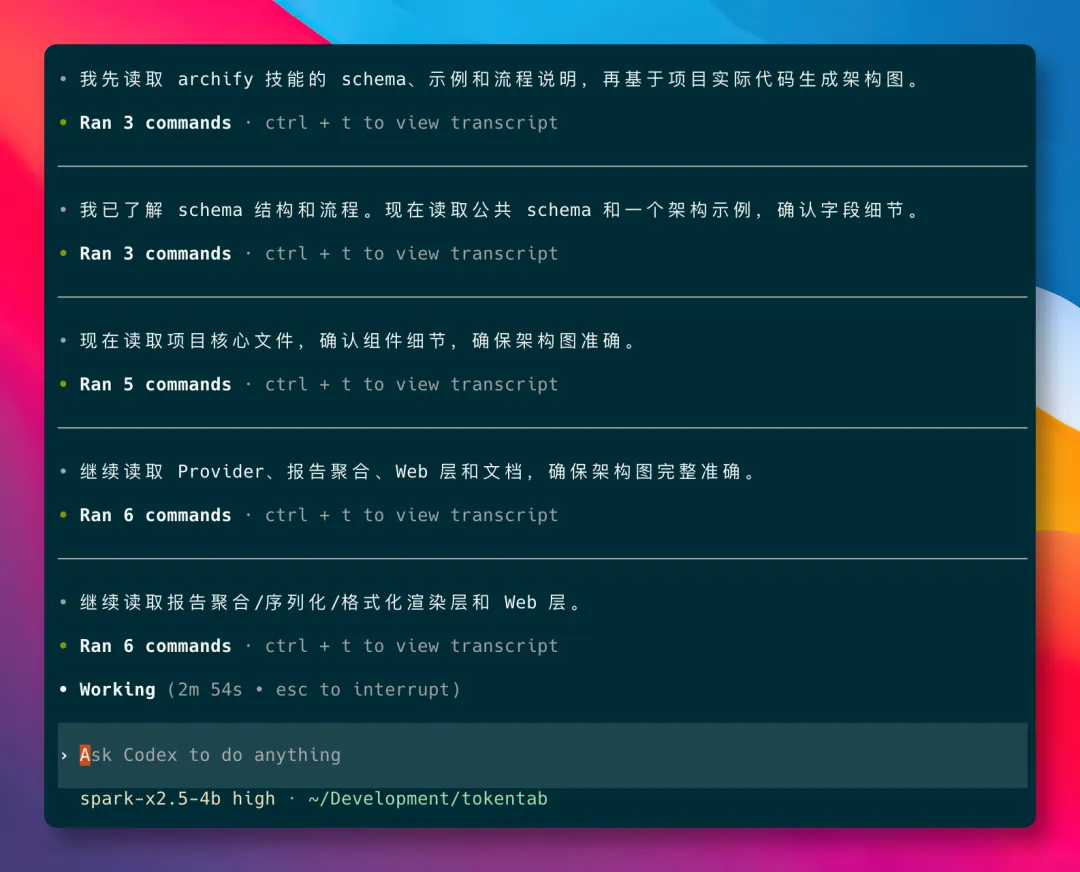
对只有 4B 参数的模型来说,这个表现有点出乎意料。
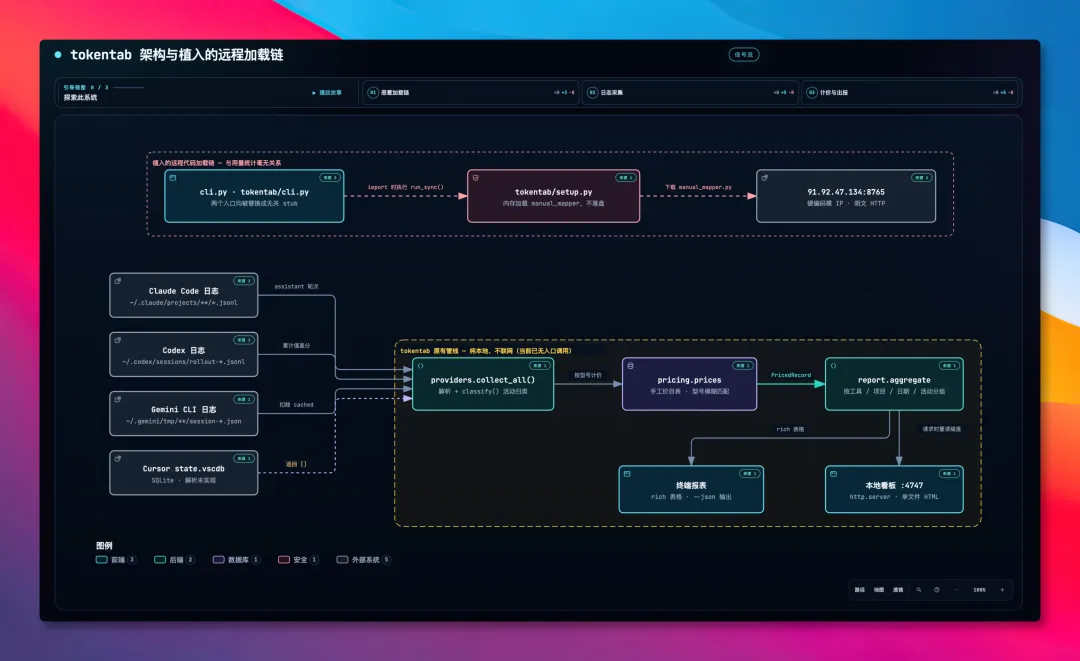
最后看 HTML 架构图的效果,整体信息量很多,看完基本对项目有了解。仔细看还是有点小问题,比如字体太小、部分组件位置放错,还少了一些动效。但对 Spark-X2.5-4B 这种端侧模型来说,做到这效果已经很好了。
端侧模型和数据敏感行业
过去大部分人可能觉得小模型就是个简单的对话玩具。这次 Spark-X2.5-4B 不仅能读完整个项目代码,还能调用工具使用技能——这些原本被认为只有大模型才有的 Agent 能力,现在一个 4B 模型跑在本地就能做到。
在我看来,真正卡住 AI 进入很多行业的,从来不是模型能力,而是自己的数据不能外出。医疗、法务、金融这些对数据极其敏感的行业,AI 需求一直在,卡的就是这一条。当模型的 Agent 能力可以装进端侧本地运行,这些行业的应用场景会大量落地。接下来一两年,端侧模型在数据敏感行业落地的案例,会比云端 Agent 更快。
目前模型权重已开源到 Hugging Face 和魔搭,可以直接下载部署;GitHub 仓库里有完整的部署文档。不想折腾本地部署的,讯飞星辰 MaaS 平台也有对应的 API 调用,目前限时免费。