3700 万浏览的 Jev:只输出概率的决策模型,和它带出的一圈开源复现
发布帖挂在那里,三千七百多万次浏览,七万多个赞。发布当天它在 Hacker News 首页挂了很久,分数冲到一千六百多。
一个不会聊天、不会写文章、不会写代码的 AI 模型,就这样火出圈了。发帖的人叫 Diogo Almeida,之前在 OpenAI 做研究员,InstructGPT 那篇论文的主要作者之一,RLHF 这套训练方法就是他参与搭起来的,ChatGPT 能这么顺着人说话,有他一份功劳。他两年前离开 OpenAI,和 Erik Gafni、Sasha Sheng 一起创办了 TypeSafe AI,闷头干了两年,前几天才结束隐身状态,同时宣布拿了 DCVC 领投的 4000 万美元种子轮。福布斯援引知情人士的说法,估值大概 2 亿美元。
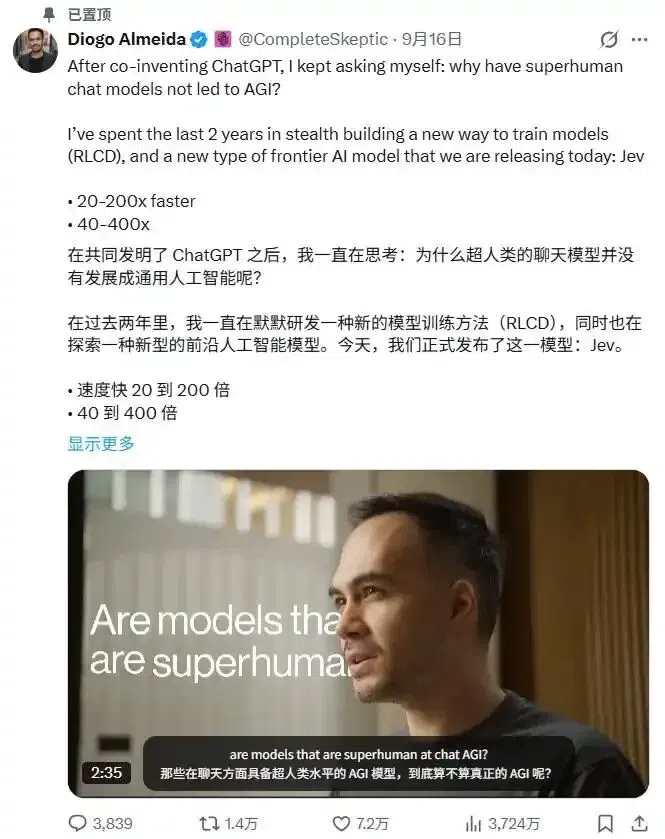
TypeSafe 创始人 Diogo Almeida 的发布帖
Jev 到底是什么
TypeSafe 管 Jev 叫 System One 模型。名字来自卡尼曼那本《思考,快与慢》,书里说人脑有两套系统:系统一负责快速的直觉判断,看到熟人的脸一眼认出来那种;系统二负责慢速的深思熟虑,算 17 乘 24 那种。Jev 想做的是前面那一套。
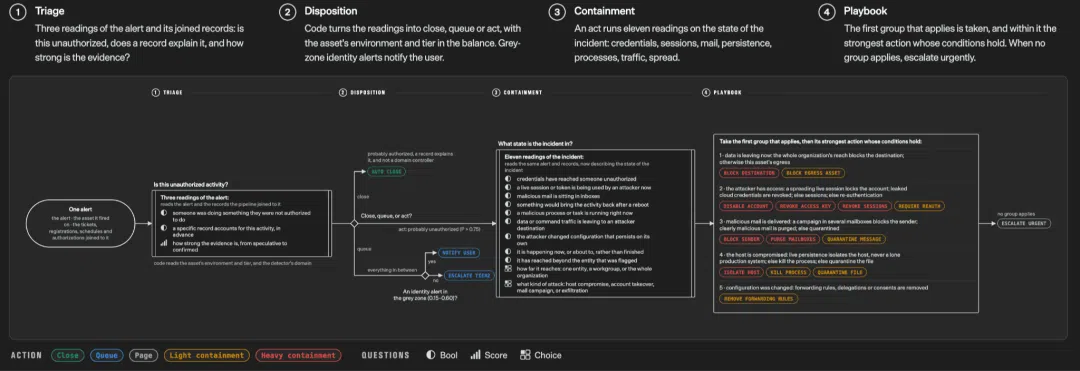
具体干什么?一句话,你给它一段状态,再给它几个提前定好的问题,它直接返回带概率的答案。官方说法是 unstructured state in, typed probabilistic decisions out——非结构化状态进去,类型化的概率决策出来。
它只回答三种问题:
- 选择题,官方叫 Choice。你给它一组选项,最多 255 个,它告诉你选哪个,顺便给出每个选项的概率。
- 打分题,叫 Score。你定一个有序的量表,比如冷静、有点烦、非常愤怒三档,它给你一个分数和对应的概率分布。
- 是非题,叫 Noul。一句话陈述,它返回这句话为真的概率,0 到 1 之间的一个数。
举个实际点的例子:
客服系统收到一封邮件,可以一次性问它四个问题:这封信该归账单组、技术组还是销售组,客户情绪到哪一档了,这事急不急,要不要人工介入。它不会回你一段分析,而是直接给一组数字,比如技术问题概率 0.87,紧急程度概率 0.96,置信度 0.82。代码拿到这些数字,下一步该走哪条流程,直接写 if 就行了。
不用解析 JSON,不用正则,不用处理模型突然给你加一句「好的,让我来分析一下」。因为压根没有文字输出,输出空间在你发问之前就定死了,它想输出格式之外的东西都做不到。
为什么不写字,反而快了
现在的大语言模型,不管多聪明,干活的方式都是自回归生成,一个 token 一个 token 往外蹦,每蹦一个都要回头看一眼前面写过的所有内容。你问它一个选择题,它会先写「根据您提供的信息,我认为……」,啰嗦三百个字,最后才说到选项 B。这三百个字全是成本和延迟,对程序没有任何用处,程序要的只是那个 B。
Jev 把这层壳剥掉了。它不做逐字生成,所有问题在一次前向计算里并行评完。所以官方给出的端到端延迟是 70 到 500 毫秒,对照组的前沿大模型是 3 到 329 秒。定价也很有意思:输入每百万 token 收 0.042 美元,输出不收钱,因为根本没有输出 token 可收。一次普通决策的成本大概在 0.0001 美元这个量级,一万次决策也就几块钱人民币的事。
官方还放了一组自己设计的工作流评测,结论是最快比对照模型快 193.6 倍,成本最多低 444.6 倍。
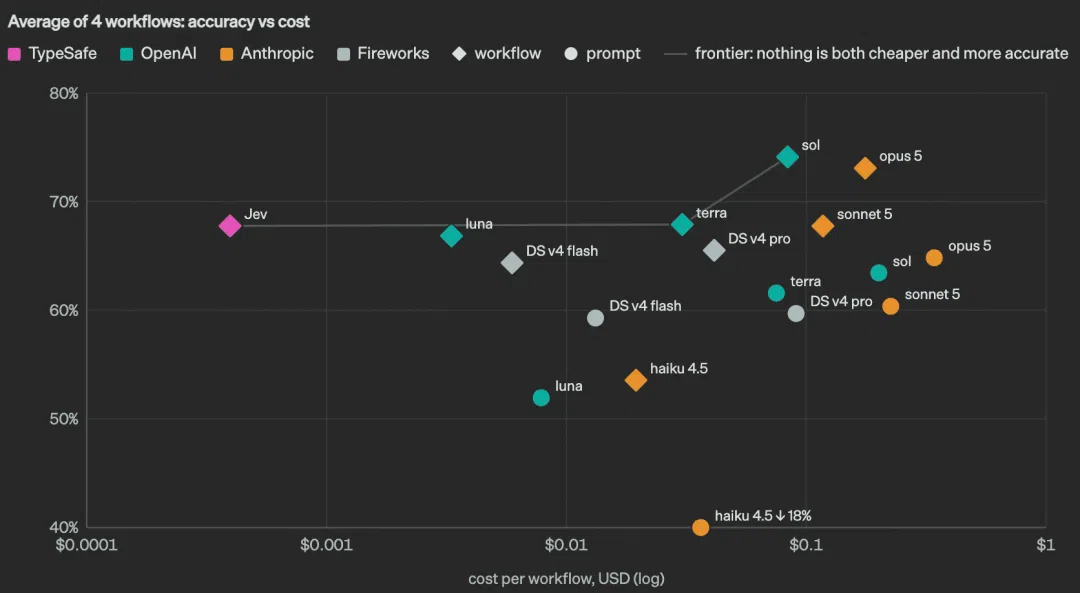
TypeSafe 官方的工作流评测,横轴是成本,纵轴是准确率,Jev 独占左上方
不过这组数字得打折看。TypeSafe 自己也承认,测试任务是自家模型能力团队做的,参考答案部分来自更强模型的生成结果,193.6 和 444.6 是特定任务上的最大差距,官方原话是这些数字处在实际收益的高端区间。
他们官网上还放了一个并排演示:同一段工单文本,Jev 用 0.114 秒一口气返回十几个判断,花了 0.000081 美元;对照的 GPT-5.6 Terra 还在一个字一个字往外写,写完用了 8.566 秒,花了 0.0138 美元。
对比确实强烈,不过这个演示的输入是特意挑过的短文本,这一点官方自己在注释里写了。拿一个专为判断设计的模型去和通用生成模型比判断题,优势肯定会被放大。所以这些数字看个量级就好,别当成「Jev 有 GPT 的智能还快两百倍」来理解。
第三方测评结果
官方数字之外,这几天第三方的结果也陆续出来了,有好有坏。
Vercel 那边,CEO Guillermo Rauch 亲自发帖,说他们给自家的 fx 工具做命令安全分类,原来用 GPT 方案,换成 Jev 之后中位延迟从 1458 毫秒降到 312 毫秒,p95 上快了 17.6 倍,准确率从 96.7% 升到 98.6%,210 次决策零回退,三次重复跑下来结果完全一致,原来那个模型倒是有一次结果不稳定。这个场景本身也很典型:每条要执行的命令先过一遍风险判断,高频、选项固定、对错分明,正好是 Jev 的主场。
LangChain 在 9 月 20 号发了一个 Jev-as-a-Judge 的实验,让 Jev 和 GPT-5.6 Luna、GPT-5.6 Terra、Claude Sonnet 4.6 一起给 Agent 的输出当评委。Jev 平均每次调用 0.44 秒,成本约 0.00035 美元,连续多次评分给的结果也很稳定。LangChain 自己也说了,这是小规模早期测试,不能下大结论。
LangChain 发布的 Jev-as-a-Judge 实验
还有一个测试,是这几天看到的里面做得最老实的。一位开发者在 primeline.cc 上发了篇文章,先把通过和失败的标准写下来再开始测,用 Jev 对比 Claude Haiku 4.5、Claude Opus 5 和 GPT-5.6,跑两个真实分类任务。结果很有意思:800 条 commit 信息分类,Jev 65.8% 排第一;450 条知识库分类,Jev 90.7%,输给了 Haiku 的 97.8%,而且在每个置信度门槛上都输。全部测试跑了差不多 9750 次调用,一共花了 0.38 美元。
他的结论是这样的:你可以从任何一个大模型那里问出同样的答案,但你拿不到同样的那个数字。意思是,准确率这事大家互有胜负,但 Jev 给的置信度是校准过的,它说 90% 把握的事,大体上真有九成是对的。有了这个,自动化分流才玩得起来——高置信度的自动放行,没把握的转人工或者转大模型复核。反过来想,一个准确率 95% 但永远不知道自己哪 5% 会错的模型,你敢让它全自动跑吗?
社区已经拿去干嘛了
发布不到一周,X 上冒出来一堆真实项目,挑几个有代表性的。
Browser Use 团队做了个 jev-ultrafast。浏览器 Agent 每走一步,页面上的可交互元素被整理成带编号的候选动作,Jev 负责决定点哪个,只有要填文字的时候才叫一个小模型出来。他们用这套东西在 Google Flights 上搜苏黎世到伦敦的航班,完整跑完一次 7.1 秒,成本 0.0039 美元。视频是原速录的。
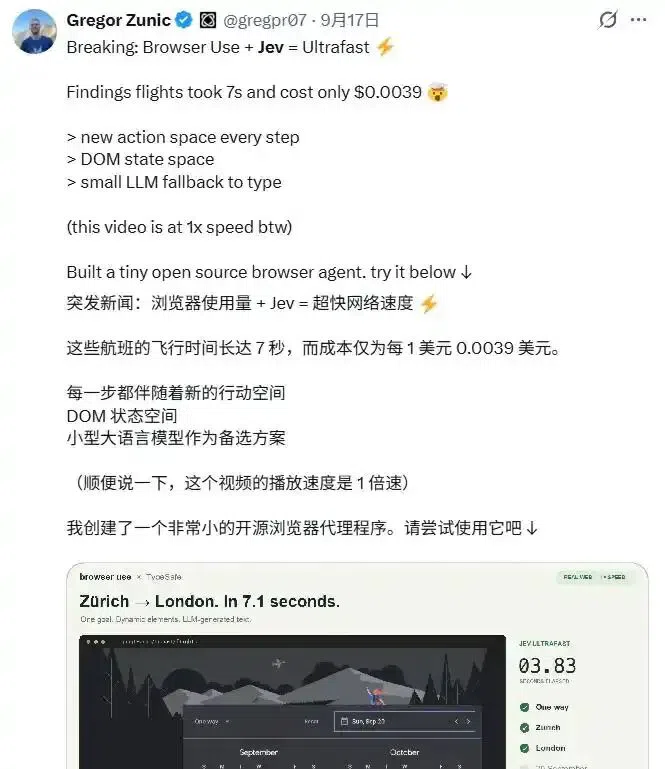
Browser Use 加 Jev 的组合,一次航班搜索 7 秒跑完
开发者 Matthew Berman 拿 Jev 分析广告:37 个品牌的 724 条实时广告,拆每条广告的钩子、形式、优惠、转化路径、用户认知阶段,一共产生 8724 次判断,40 秒跑完,token 成本 9 美分。
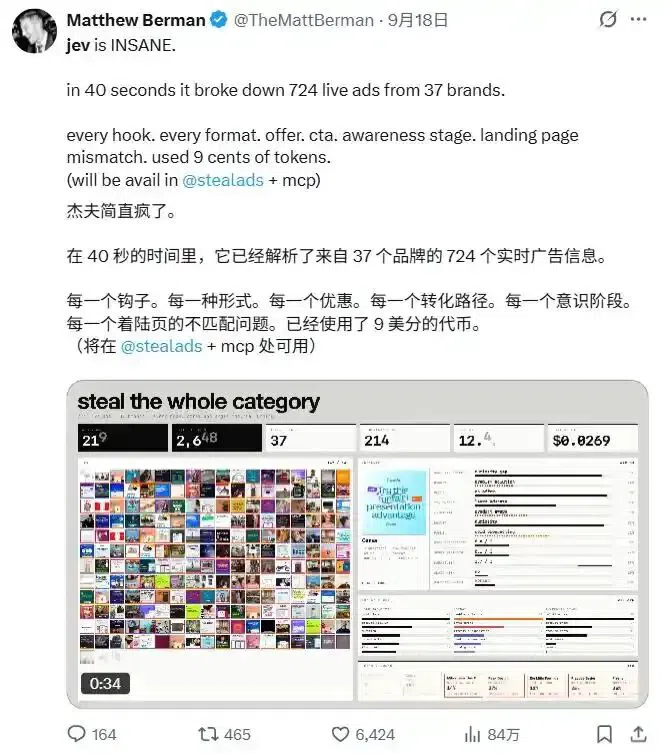
724 条广告,40 秒,8724 次判断,9 美分
还有一个叫 fast-jev-compaction 的 Claude Code 插件,想法很刁钻。用 Claude Code 干活的时候,上下文会越堆越长,现在的做法是让模型自己总结压缩。这个插件把每次工具调用和终端输出交给 Jev 打分,判断哪些还跟当前任务有关,无关的直接丢掉,压缩从「写摘要」变成了「做判断」。上线几天就被移植了好几个版本。
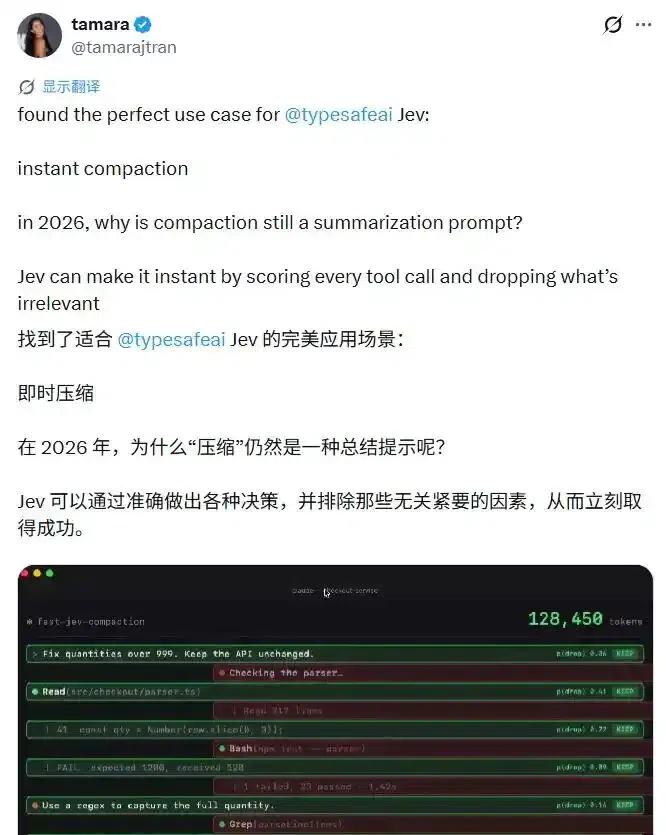
fast-jev-compaction,用 Jev 给每条上下文打分决定去留
剩下的还有拿它玩超级马里奥和 Doom 的,每秒十次决策。官方博客里写了个细节:做 Doom 演示的工程师一开始担心每秒查询十次太烧钱,算完账发现一小时大概 7 美元,团队其他人的反应是比预想的便宜。另外有拿它做模型路由的,先判断这个请求该发给哪个档位的大模型;也有拿它做实时交易机器人的,每 300 毫秒判断一次买还是卖。
这些项目有个共同点:没人拿 Jev 聊天,全是把它塞进软件流程里,干那些一天要重复几十万次的小判断。
Jev 本身并不开源
说实话,一开始容易默认这么火的东西肯定开源了,查一下才发现并没有。
Jev 是闭源的,只有托管 API,没有权重,没有自托管,参数量和架构都没公布,论文也没有。而且按照目前的报道,它还没有对中国大陆地区开放。所以这篇也不会有什么接入教程,想直接调 API 对大部分国内开发者来说现在不现实。
但它的设计思路在公开文档里写得挺明白:输入长什么样、输出长什么样、怎么评估,都有。所以这几天全球冒出一批开源复现和同类项目,对国内开发者来说,这部分才是真正能上手的。
国内动作最快的是 APUS。9 月 19 号他们旗下 AI 实验室放出了 APUS-AI-Lab/fast-browser-use,算是全球最早一批独立复现,MIT 协议,macOS、Linux、Windows 都能跑,没 GPU 的普通 Mac 和 PC 也能跑。做法是用本地模型复现这套机制,场景选在浏览器自动化上,页面元素编成候选动作,本地跑一个 Qwen3.5-9B,一次前向计算直接决定点哪里。
他们自己测的数据是:一台 M2 Pro 笔记本全程离线,完成一个真实百科网站检索任务中位耗时 18 秒左右,填表单、站内导航这种 3 秒上下,零云端调用,数据不出本机。项目封装成了标准 Agent Skill,可以接进 Claude Code、Codex、OpenCode。

fast-browser-use 的实测演示,本地 Qwen3.5-9B 跑百科检索,单次决策中位 79 毫秒
国外也有几个。
vinnylarouge/jevlike 是一个从零训练的小模型,思路是把每个选项编码成查询向量,各自从上下文里抽取跟自己相关的信息再打分,所有选项并行比一遍,谁分高选谁。不挂预训练编码器也能学,挂上效果更好。
Bespoke Labs 开源了 Nimble,9B 参数,号称两天训完,留出测试集准确率 90.12%,比没微调的 27B 模型高 5 个点,他们自己直接管这叫开放式 Jev。
Jared Palmer 那个 Kev 更适合普通开发者玩。0.6B、4B、8B 三个尺寸,API 兼容 TypeSafe 的格式,MacBook 上就能训能跑。他还做了个网页 playground,左边贴状态和问题,右边直接出概率分布,不用写代码就能感受这套交互是怎么回事。
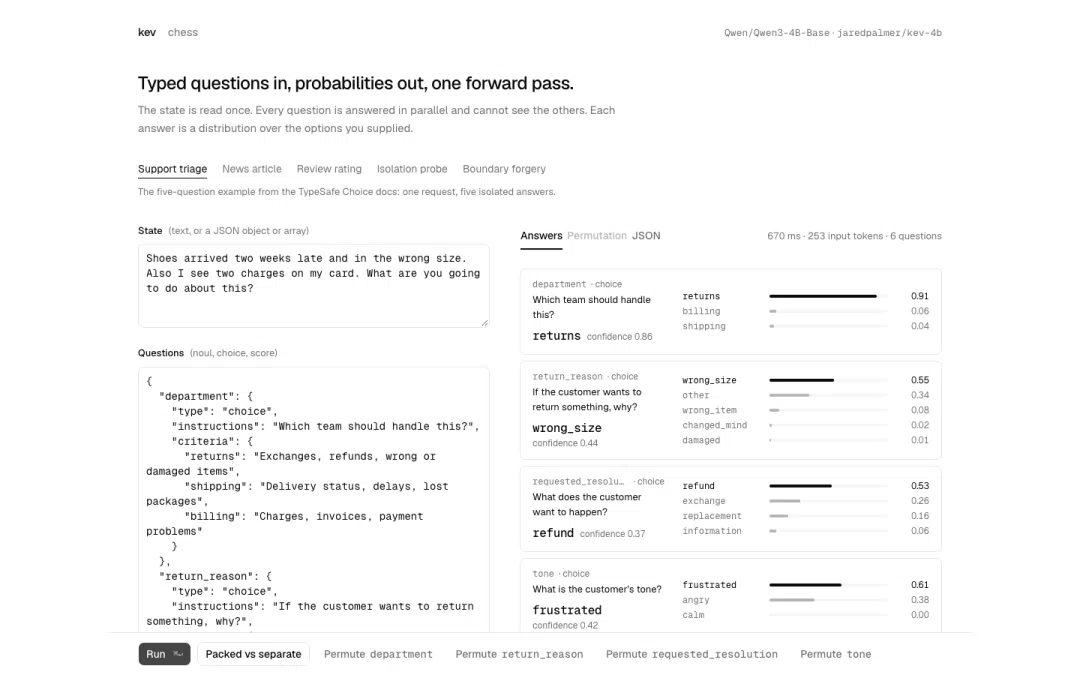
Kev 的网页 playground,左边贴状态和问题,右边直接返回概率
他们自己还跑了一组对比,在 Kev 没训练过的数据源上跟 Jev 比准确率,最大的 8B 版本还差几个点,但看看体积,这个表现已经很能打。
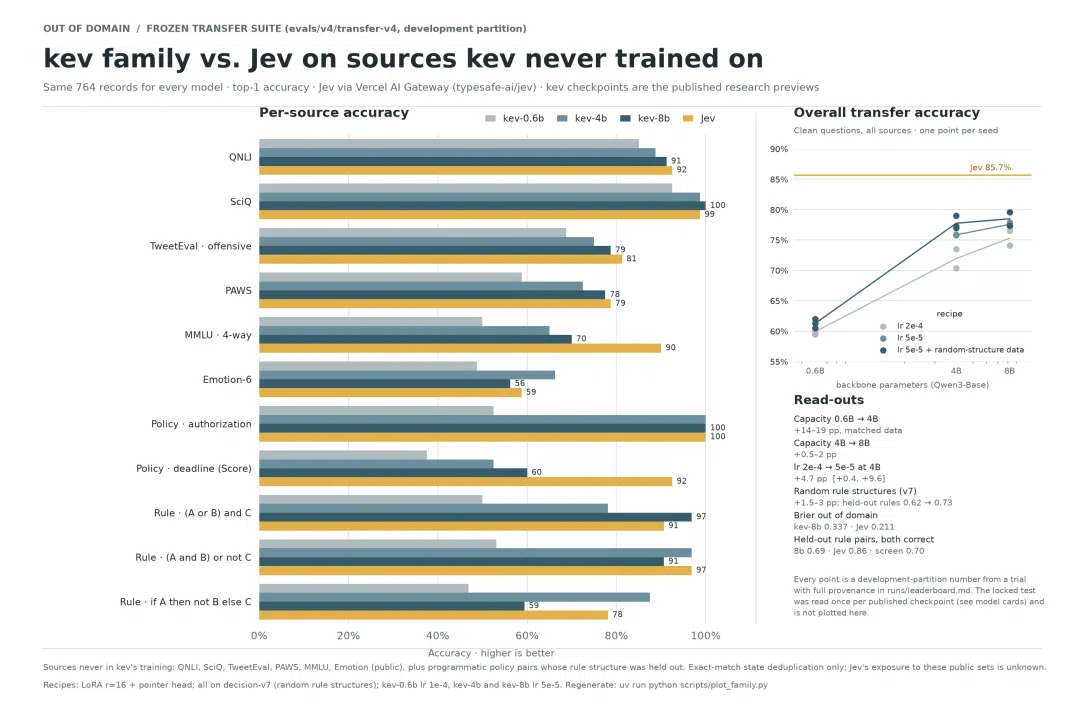
Kev 官方对比测试,kev 三个尺寸 vs Jev,数据源都是 kev 没训练过的
另外还有一个叫 Laya 的开源决策模型家族,宣称商用硬件上 32.8 毫秒出结果。中文圈也有人做了导航站,GitHub 上的 yzfly/awesome-jev-zh,官方资料和复现项目都收在一起了,想深挖的话从那里进比较方便。
所以情况是:Jev 这个模型本身摸不着,但它这套做法已经被社区照着做出来了,还有了能在自己机器上跑的版本。
谈谈我的看法
Jev 算不上什么新物种。分类和路由这种事,大家一直在凑合着做,一个 Agent 任务跑下来,大部分调用干的其实是判断的活,谈不上创作。以前我们要么自己训个小模型,要么让大模型写一段话再从里面解析答案,都挺别扭。Jev 把这件事做成了正经产品,价格和延迟也压到了可以随便用的程度。
我觉得比起快,更值钱的是那个校准过的置信度。快和便宜,通用小模型迟早能追上来,但「我说 90% 就真有九成对」这件事,聊天模型天生做不好,因为犹犹豫豫的回答不讨人类喜欢,训练的时候就被筛掉了。所以比起 193 倍这种数字,我更关心 RLCD 这套训练方法能不能被独立验证。不过目前只有官方说法,没有论文和第三方复核,在自己的数据上量一遍之前,谁的话都别全信。
零幻觉的宣传也要看清楚。它保证的是输出永远落在你定义的选项里,格式错误为零,这是机制决定的,不是实测出来的。但格式对和判断对是两码事,输入明明是只猫,它返回狗 97%,格式上挑不出毛病,业务上全错了。
TypeSafe 官方给出的结构化输出和工具调用错误率对比,Jev 是 0%,官方注明这是机制保证而非实测结果
我更好奇的是它对 Agent 架构的影响。以后一套系统大概率是分工的:贵的大模型负责规划和生成这些慢思考,便宜的决策模型负责高频快判断,确定性的部分继续用普通代码,中间的调度层社区叫它 Harness。不是所有需要智能的地方都需要调一个生成式大模型。
至于是不是新范式,现在下结论太早。通用模型也在变快变便宜,Jev 的领先优势能保持多久没人知道,更别说它到现在还是个摸不到权重的闭源服务。不过它确实让一个问题被更多人看到了:软件里那些海量的小判断,以前都是凑合处理的,现在至少有了新选择。